Каждый, кто пробовал собирать регулярный видеоконтент без собственного присутствия в кадре, неизбежно упирался в коммерческие платформы вроде HeyGen. Схема знакома: 30–50 долларов в месяц за пару десятков минут генерации, жесткие лимиты на разрешение, водяные знаки на базовых тарифах и ощущение зависимости от чужого закрытого сервиса. А бесплатные открытые решения прошлых поколений (вроде SadTalker или ранних версий Wav2Lip) выдавали «эффект зловещей долины»: дрожащие зубы, размытые рты и застывшее тело манекена, которое замирает, как только замолкает аудиодорожка.
Но индустрия видеогенерации сделала колоссальный скачок. Китайский технологический гигант Meituan (команда Meituan LongCat) выкатил в открытый доступ под свободной лицензией MIT флагманский движок LongCat-Video-Avatar 1.5. Это готовая система синтеза цифровых людей коммерческого уровня, способная генерировать длинные, стабильные видео с идеальной синхронизацией губ, естественной мимикой, микрожестами и сохранением идентичности лица без какого-либо дрифта со временем.
Что внутри LongCat-Video-Avatar 1.5: Архитектурный прорыв
Большинство генераторов аватаров страдают от двух фундаментальных болячек: накопление ошибки на длинных видео (лицо через 10 секунд начинает плыть и деформироваться) и неестественная застывшая поза в паузах между фразами. Разработчики Meituan решили обе проблемы на уровне базовой DiT-архитектуры (Diffusion Transformer):
- Аудиоэнкодер Whisper-Large вместо Wav2Vec2: В версии 1.5 авторы полностью отказались от старых энкодеров речи в пользу Whisper-Large. Это обеспечило точнейшее понимание смысловой и эмоциональной окраски звука — движения губ, округление звуков и смыкание челюсти стали плавными и неотличимыми от живого человека.
- Развязка речи и движения тела (Disentangled Unconditional Guidance): Модель четко разделяет речевой сигнал и естественную моторику тела. Когда спикер делает паузу на вдох или логическую запятую, аватар не «замораживается» в кадре — он продолжает моргать, покачивать головой, сохраняя естественное дыхание и микродинамику.
- Дистилляция в 8 шагов (DMD2 Step Distillation): Классические диффузионные видеомодели требуют 30–50 шагов инференса на кадр, что делало продакшн мучительно долгим. В LongCat 1.5 применена передовая дистилляция шагов на базе DMD2, сократившая генерацию всего до 8 NFE (Number of Function Evaluations). Это дает колоссальную скорость инференса и делает развертывание коммерчески выгодным даже на относительно доступных GPU.
- Универсальная мультидоменность: Модель великолепно работает не только с реалистичными людьми, но и с аниме-персонажами, 3D-маскотами, животными, а также поддерживает многопользовательские диалоги (Multi-Person Conversation) и удержание предметов в руках.
Три ключевых режима генерации
Движок поддерживает три нативных формата работы, закрывая 100% потребностей современного контент-завода:
- ATI2V (Audio-Text-Image to Video): Вы подаете одну фотографию человека (например, ваш портрет или сгенерированное лицо) + аудиодорожку голоса. Модель оживляет статичный кадр в полноценное живое видео нужной длины.
- AT2V (Audio-Text to Video): Генерация аватара с нуля чисто по текстовому описанию внешности и аудиофайлу (без исходного фото).
- Video Continuation (Бесшовное продолжение видео): Продление уже сгенерированного ролика или живого видеопотока без скачков кадров, разрывов освещения и изменения позы.

Бенчмарки: Сравнение с InfiniteTalk и коммерческими решениями
Команда Meituan провела масштабное слепое тестирование. Было сформировано 508 тестовых пар (голос + изображение) в 6 прикладных сценариях: теленовости, обучающие ролики, бытовые влоги, развлекательный контент, вокал и e-commerce реклама на двух языках (английский и китайский).
В субъективном тесте 770 независимых оценщиков выставили 13 240 оценок по 5-балльной шкале правдоподобия. А 10 экспертов компьютерного зрения проанализировали ролики по 4 критериям: физическая правдоподобность, гармония звука и артикуляции, временная стабильность и сохранение идентичности лица.

Результат: LongCat уверенно обошел недавний InfiniteTalk и зафиксировал новый золотой стандарт среди open-source решений, приблизившись вплотную к закрытым платным сервисам уровня HeyGen 3.0.
Как протестировать прямо сейчас: Два варианта запуска
Вариант 1. Без установки (Hugging Face Spaces)
Для быстрого знакомства и проверки своего фото с голосом разработчики развернули готовые демо-интерфейсы на Hugging Face:
- Страница модели и технический репорт: huggingface.co/meituan-longcat/LongCat-Video-Avatar-1.5.
- Официальная галерея с десятками примеров: meigen-ai.github.io/LongCat-Video-Avatar.
Вариант 2. Локально или на сервере (Diffusers & Transformers)
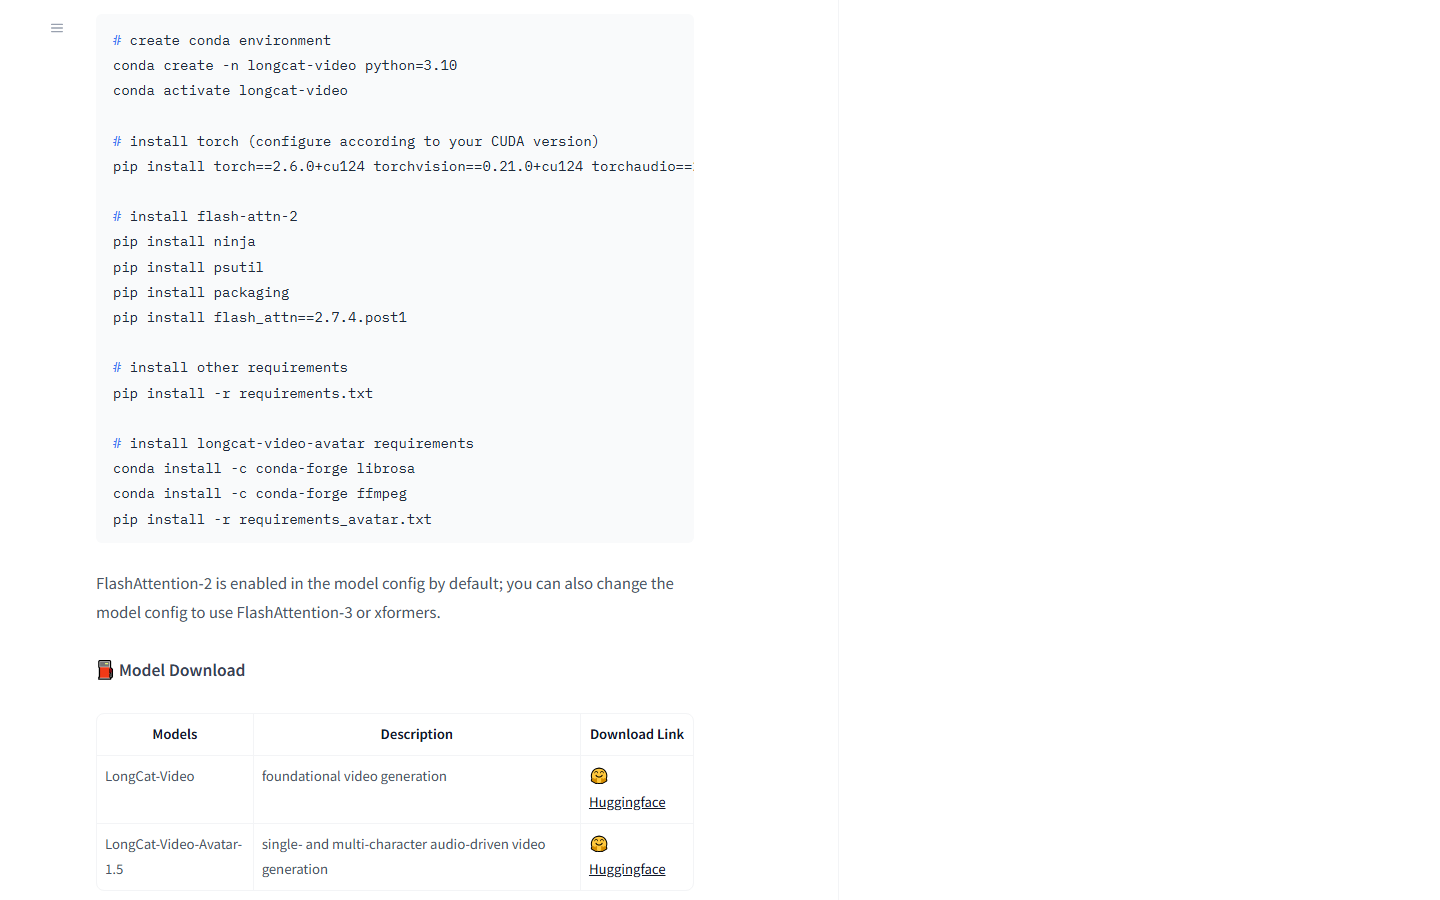
Если вы строите автономную фабрику контента, модель полностью интегрируется в стек Diffusers с поддержкой FlashAttention-2 или FlashAttention-3:
# Клонирование репозитория и установка зависимостей
git clone https://github.com/meituan-longcat/LongCat-Video-Avatar.git
cd LongCat-Video-Avatar
pip install -r requirements.txt
pip install flash-attn --no-build-isolation
Пример инференса через Python в режиме 8-шаговой дистилляции:
import torch
from longcat.pipeline import LongCatAvatarPipeline

pipe = LongCatAvatarPipeline.from_pretrained(
    "meituan-longcat/LongCat-Video-Avatar-1.5",
    torch_dtype=torch.bfloat16,
    use_safetensors=True
).to("cuda")

# Генерация аватара по фото и аудио
video = pipe(
    image="input_avatar.jpg",
    audio="speech_track.mp3",
    num_inference_steps=8,
    guidance_scale=2.5,
    height=704,
    width=1280
).frames

video[0].save("output_avatar.mp4")
Требования к железу: Для генерации видео в разрешении 720p/1080p в режиме FP16/BF16 рекомендуется видеокарта с 16–24 ГБ VRAM (RTX 3090, RTX 4090, A100 или облачные инстансы на RunPod/Vast.ai). Для оптимизации потребления памяти можно включить xformers или CPU Offload.
Как встроить LongCat в AI-контент-завод на n8n
Для коммерческого применения нет смысла крутить инференс руками. В экосистеме автоматизации n8n архитектура выстраивается следующим образом:
- Генерация сценария и хука: LLM (Gemini 3.8 Pro с Thinking Mode или GPT-5) генерирует вирусный сценарий на основе трендов ниши.
- Синтез голоса: Озвучка через локальный Piper/F5-TTS или ElevenLabs со скоростью 1.15–1.2x для динамики.
- Webhook в LongCat Worker: n8n отправляет аудиофайл и фотографию спикера на GPU-воркер через FastAPI вебхук.
- Pro-монтаж: Полученное видео аватара подхватывается движком автонарезки (Remotion/HyperFrames), накладываются опережающие субтитры, саунд-дизайн, зумы камеры и фирменный стиль.
- Автопубликация: Готовый ролик отправляется в Telegram, Reels, YouTube Shorts и TikTok по расписанию.
Итог
Релиз LongCat-Video-Avatar 1.5 окончательно доказывает: эра закрытых дорогостоящих платформ для синтеза аватаров подходит к концу. Открытый код, лицензия MIT, 8-шаговый инференс и кинематографическая стабильность делают технологию доступной для любого эксперта или бизнеса, готового выстроить свой автономный медиа-продакшн.
🎁 Забирай готовую инструкцию по запуску AI-двойника
Напиши кодовое слово аватар в нашего Telegram-бота — и забирай пошаговый гайд по быстрому развертыванию своего AI-двойника, шаблоны промптов и схему воркфлоу n8n:
👉 Запустить бота и получить инструкцию: @ai_websansaybot (или пиши в канал @ai_websansay)